
SAA 的選項很少出現完全做不到的服務。比較常見的情況是四個選項來自同一類服務,每個都能運作,只有一個符合題目寫出的條件。例如題目要把訂單事件送給三個系統,SQS、SNS、EventBridge、Kinesis 都能把訊息送出去,差別藏在「三個系統都要拿到完整資料」或「要能重新處理昨天的資料」這類句子裡。
這篇沿著一個電商網站從下單到出報表的流程,把每個環節會遇到的一組相似服務放在一起:它們為什麼看起來能互相取代、真正的差別在哪個機制、題目的哪些字決定答案,以及錯誤選項通常長什麼樣子。
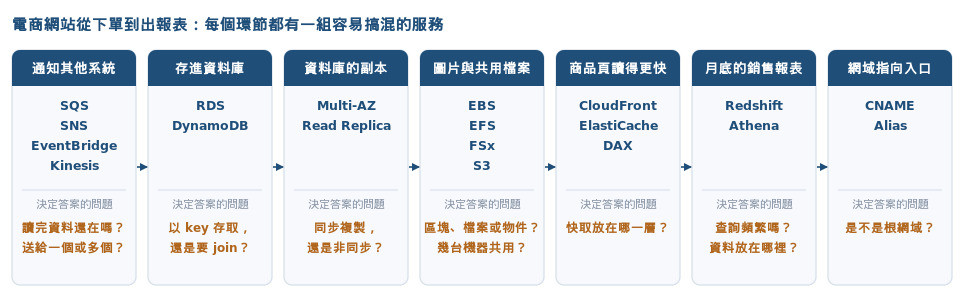
情境:訂單成立後,出貨、寄送確認信、更新推薦系統都要知道這件事。
這四個服務都能把資料從一個系統送到另一個系統。分辨它們看兩件事:資料被讀取之後還在不在,以及一筆資料會送給幾個接收者。
| 資料被讀取後 | 一筆資料送給誰 | |
|---|---|---|
| SQS | 處理完就刪除;沒處理的最多保存 14 天 | 一個消費者 |
| SNS | 不保存,收到就立刻推送 | 所有訂閱者 |
| EventBridge | 不保存,但可以封存後重新播放 | 符合 rule 的目標 |
| Kinesis Data Streams | 保存到保存期限結束(24 小時到 365 天) | 每個應用程式各自讀取完整資料 |
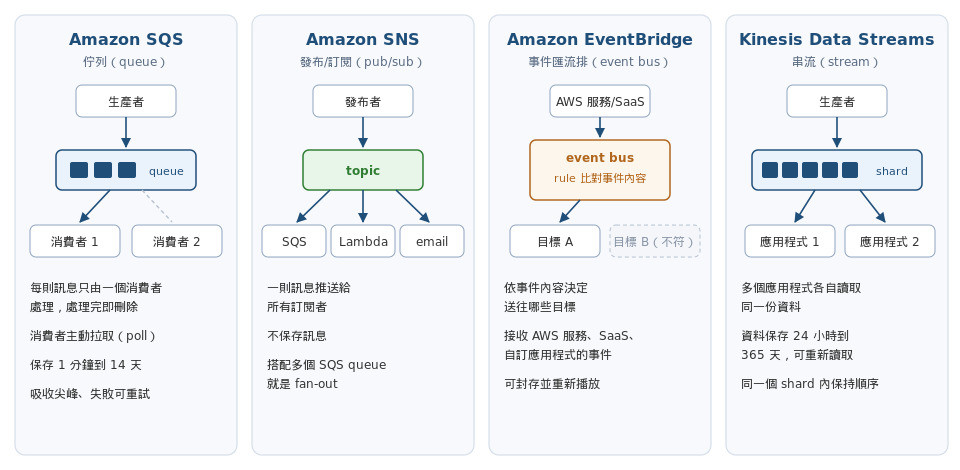
SQS 是佇列,消費者主動拉取(poll)訊息,處理完就刪除,所以多個消費者讀同一個 queue 時,每則訊息只會被其中一個處理。SNS 是發布/訂閱,訊息送到 topic 後立刻推送給所有訂閱者,本身不保存。EventBridge 同樣能送給多個目標,但由 rule 比對事件內容決定送給誰,而且能直接接收 AWS 服務(例如 EC2 狀態改變)與 SaaS 夥伴產生的事件。Kinesis Data Streams 的資料不會因為被讀取而刪除,每個應用程式各自記錄讀到的位置,所以能讀取同一份完整資料,也能從較早的位置重新讀取。
最常互相混淆的是兩組:
| 題目寫的 | 選擇 |
|---|---|
| 前後端解耦、吸收流量尖峰、處理失敗要能重試 | SQS |
| 嚴格依照順序、不可重複處理 | SQS FIFO queue |
| 一則訊息同時交給多個系統各自處理 | SNS 搭配多個 SQS queue(fan-out) |
| 依事件內容分流;處理 AWS 服務或 SaaS 的事件 | EventBridge |
| 大量即時資料、多個應用程式讀同一份資料、需要重新讀取 | Kinesis Data Streams |
| 把串流資料寫進 S3 或 Redshift,不撰寫消費程式 | Amazon Data Firehose |
常見的錯誤選項:多個系統都要完整資料,選項卻讓它們共用一個 SQS queue,訊息會被瓜分;需要重新處理過去的資料,選項卻用 SNS 加 SQS 的 fan-out,訊息處理完就刪除了。
情境:訂單、會員資料、購物車都要存進資料庫,應用程式隨時在讀寫。
兩者都是受管的資料庫,都能處理應用程式日常的大量小筆讀寫,題目寫「高流量」「低延遲」時兩個看起來都對。差別在資料怎麼被查詢。
Amazon RDS 是關聯式資料庫:資料存在資料表中,可以用 SQL 任意組合查詢條件、join 多個資料表,並在一個交易中同時修改多個資料表。代價是寫入量增加時主要靠換更大的 instance,擴展有上限。
Amazon DynamoDB 以 partition key(可再加 sort key)存取資料,資料依 key 分散到多個分區,所以無論資料量多大,以 key 讀寫都維持毫秒級延遲;on-demand 模式依實際請求計費,不必預估流量。代價是查詢方式要事先設計:以 key 以外的欄位查詢需要另外建立索引,否則只能 Scan 整個資料表。
| 題目寫的 | 選擇 |
|---|---|
| 既有的 MySQL、PostgreSQL、Oracle、SQL Server,搬上雲不改應用程式 | RDS |
| join、跨資料表交易、查詢條件經常變化 | RDS |
| 關聯式資料,需要更高的效能與可用性 | Aurora |
| 以 key 讀寫(購物車、session、遊戲狀態)、流量難以預測、不管理伺服器 | DynamoDB |
| DynamoDB 的讀取延遲要再降到微秒級 | DynamoDB Accelerator(DAX) |
常見的錯誤選項:把依賴 join 與交易的既有應用程式搬到 DynamoDB,必須改寫應用程式;用 DynamoDB 的 Scan 做大範圍的彙總,既慢又昂貴。
情境:促銷期間讀取量暴增,拖慢了資料庫;另外,資料庫所在的 AZ 故障時,網站不能停止服務。
兩者都會在另一個位置建立一份資料庫的副本,所以常被放在一起。差別在副本的用途,而用途是由複製方式決定的。
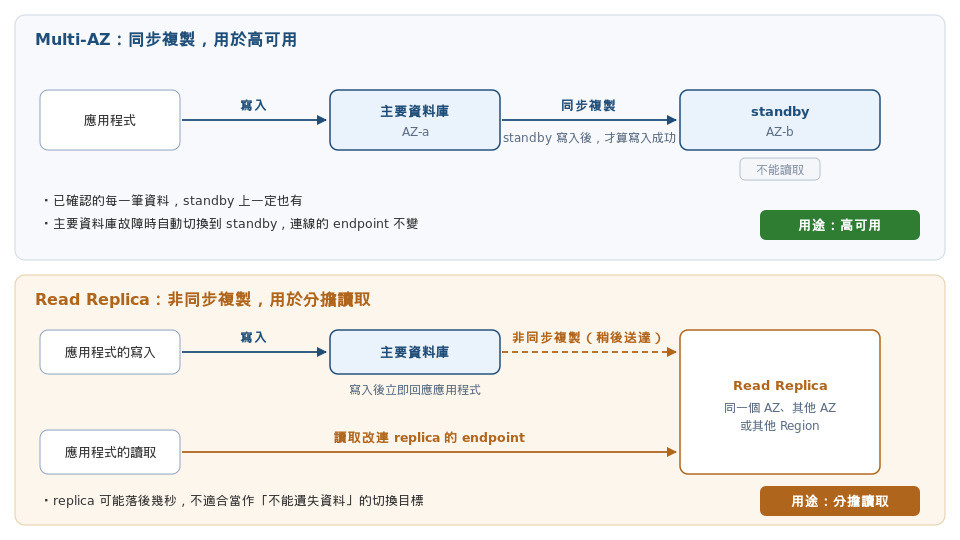
Multi-AZ 以同步方式複製:每筆寫入要等另一個 AZ 的 standby 也寫入後才算完成,主要資料庫故障時切換到 standby,不會遺失已確認的資料,連線的 endpoint 也不變。Multi-AZ DB instance 的 standby 只用於切換,不能讀取。
Read Replica 以非同步方式複製:主要資料庫寫入後立即回應,再把變更傳給 replica,所以 replica 可能落後一點。應用程式把讀取改連 replica 的 endpoint,就能分擔主要資料庫的讀取。因為可能落後,replica 不適合當作不能遺失資料的切換目標;它可以手動升級為獨立的資料庫,也可以建在其他 Region。
Aurora 的做法不同:Aurora Replica 和主要 instance 共用同一個儲存層,可以讀取,同時也是故障時的切換目標。跨 Region 則用 Aurora Global Database,複製延遲通常低於 1 秒,Region 故障時可以把次要 Region 升級為主要,接手寫入。
| 題目寫的 | 選擇 |
|---|---|
| AZ 故障時自動切換、不遺失資料、不改連線位址 | Multi-AZ |
| 讀取量太大拖慢主要資料庫;報表查詢 | Read Replica |
| 其他 Region 的使用者要低延遲讀取 | cross-Region Read Replica,或 Aurora Global Database |
| Region 故障時,在另一個 Region 數分鐘內接手寫入 | Aurora Global Database |
常見的錯誤選項:用 Read Replica 達成「不遺失資料的自動切換」,非同步複製做不到;讓 Multi-AZ 的 standby 分擔讀取(RDS 另有 Multi-AZ DB cluster 部署,兩個 standby 可以讀取,但都在同一個 Region,解決不了其他 Region 的延遲)。
情境:每台 web 伺服器需要開機磁碟,多台伺服器要共用使用者上傳的檔案,商品圖片要大量保存並供下載。
這些服務都能「存資料」,分辨時依序看三件事:存取方式(區塊、檔案、物件),有幾台機器、在幾個 AZ 要共用,最後才是作業系統與效能。
| 存取方式 | 共用範圍 | 資料能否保存 | |
|---|---|---|---|
| EBS | 區塊(像一顆硬碟) | 一台 EC2,同一個 AZ | 能 |
| instance store | 區塊,實體主機上的磁碟 | 所在的那台 EC2 | instance 停止或終止就消失 |
| EFS | 檔案(NFS,Linux) | 多台 EC2,跨 AZ | 能 |
| FSx for Windows File Server | 檔案(SMB,整合 Active Directory) | 多台 Windows 機器 | 能 |
| FSx for Lustre | 檔案,極高吞吐量 | HPC、機器學習的運算節點,可連接 S3 | 能 |
| S3 | 物件(HTTP API) | 不限,任何有權限的用戶端 | 能 |
| 題目寫的 | 選擇 |
|---|---|
| 單一 EC2 的開機磁碟或資料庫磁碟 | EBS |
| 最高的 IOPS,資料可以遺失(暫存檔、快取) | instance store |
| 多台 Linux EC2 跨 AZ 共用同一個檔案系統 | EFS |
| Windows 應用程式的檔案共用 | FSx for Windows File Server |
| HPC、機器學習,資料來源在 S3 | FSx for Lustre |
| 數量不限的檔案、靜態網站、資料湖、備份 | S3 |
| 地端應用程式以檔案或磁碟的方式使用 AWS 的儲存 | AWS Storage Gateway |
常見的錯誤選項:讓多台跨 AZ 的 EC2 共用一個 EBS volume,EBS 綁定在一個 AZ(io1/io2 的 Multi-Attach 也只限同一個 AZ);Windows 伺服器掛載 EFS,EFS 不支援 Windows;把需要保存的資料放在 instance store。
情境:商品頁每秒被讀取上萬次,內容大多很少變動,資料庫的讀取負載越來越高。
這三個服務都是快取,把常被讀取的資料放在更快的地方,減少對後端的請求。差別在放在哪一層,而位置決定了能快取什麼。
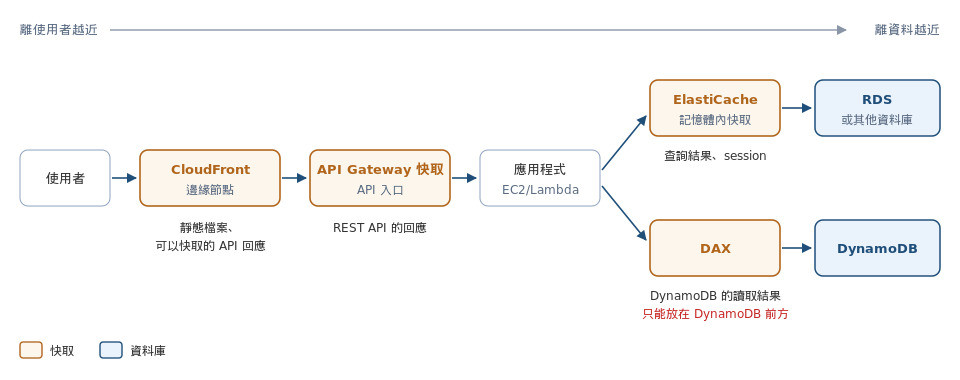
| 位置 | 服務 | 快取的內容 |
|---|---|---|
| 邊緣,離使用者最近 | CloudFront | 靜態檔案、可以快取的 API 回應 |
| API 入口 | API Gateway 的快取 | REST API 的回應 |
| 應用程式與資料庫之間 | Amazon ElastiCache | 資料庫的查詢結果、使用者的 session |
| DynamoDB 前方 | DAX | DynamoDB 的讀取結果 |
Amazon ElastiCache 是記憶體內(in-memory)的受管快取,應用程式自己決定要把什麼放進去,所以能放在任何資料庫前面。把 session 存進 ElastiCache,web 伺服器就不保存使用者狀態(stateless),Auto Scaling 增減 instance 時使用者不會被登出。DAX 只能放在 DynamoDB 前方,但它與 DynamoDB 的 API 相容,應用程式幾乎不用修改。
快取的資料還有一組常被比較的更新策略:
| 策略 | 運作方式 | 優點 | 缺點 |
|---|---|---|---|
| Lazy loading(cache-aside) | 讀取時先查快取;沒有(cache miss)才查資料庫,再把結果寫入快取 | 只快取真正被讀取的資料 | 第一次讀取較慢;資料庫更新後,快取可能是舊資料 |
| Write-through | 寫入資料庫時,同時更新快取 | 快取中的資料一直是最新的 | 每次寫入多一個步驟;快取中可能有從來沒被讀取的資料 |
兩種策略都會搭配 TTL(time to live):快取的資料在設定的時間後自動過期,下次讀取時重新從資料庫取得,避免舊資料一直留在快取中。
常見的錯誤選項:在 RDS 前方加 DAX,DAX 只支援 DynamoDB;快取建在資料所在的 Region,遠方使用者的請求仍要跨 Region;資料經常變動卻設定很長的 TTL。
情境:每個月要彙總過去數年的銷售資料,產生報表與 BI 儀表板。
應用程式日常的小筆讀寫稱為 OLTP(online transaction processing),RDS 與 DynamoDB 都屬於這類;對大量歷史資料做彙總分析稱為 OLAP(online analytical processing)。題目出現「彙總多年資料」「BI 報表」時,答案通常不是交易用的資料庫,而是 Redshift 或 Athena。兩者都用 SQL 分析大量資料,差別在資料放在哪裡、怎麼計費。
Amazon Redshift 是資料倉儲:資料先載入 Redshift,以欄式儲存(只讀取查詢用到的欄位)與多節點平行處理執行查詢。適合頻繁、複雜的查詢與固定使用的 BI 儀表板,費用依叢集規模計算(也有 Serverless 選項)。
Amazon Athena 不需要載入資料,直接以 SQL 查詢 S3 上的檔案,沒有伺服器要管理,依每次查詢掃描的資料量計費。適合不定期、臨時的查詢,例如分析存在 S3 的日誌;把檔案轉成 Parquet 這類欄式格式並分割(partition),能減少掃描量與費用。
| 題目寫的 | 選擇 |
|---|---|
| 大量資料的複雜分析、每天頻繁查詢、BI 儀表板 | Redshift |
| 直接以 SQL 查詢 S3 上的檔案、查詢不頻繁、不管理伺服器 | Athena |
常見的錯誤選項:把交易用的 RDS 換成更大的 instance 來跑分析查詢;每天數百次掃描完整資料的查詢用 Athena,累積的掃描費用比 Redshift 高。
情境:網站的入口是一個 ALB,要讓 example.com 與 www.example.com 都指向它。
兩種 Route 53 記錄都能把網域名稱指向另一個名稱。CNAME 是 DNS 標準的記錄,回傳另一個網域名稱;DNS 規定 CNAME 不能和同名的其他記錄並存,而根網域(example.com)一定有 SOA 與 NS 記錄,所以根網域不能用 CNAME。Alias 是 Route 53 的擴充功能,Route 53 直接查出 AWS 資源的 IP 回傳,因此根網域也能使用。
| CNAME | Alias | |
|---|---|---|
| 指向的目標 | 任何網域名稱 | AWS 資源(ELB、CloudFront、S3 靜態網站、同一個 hosted zone 的其他記錄等) |
| 能否用於根網域 | 不能 | 能 |
| 查詢費用 | 收費 | 指向 AWS 資源時免費 |
常見的錯誤選項:在根網域建立 CNAME 指向 ALB;用 Alias 指向 AWS 以外的網域名稱。
考試中偶爾出現、但不太會和上面的服務互相混淆的資料庫,認得用途即可:
| 題目寫的 | 選擇 |
|---|---|
| 資料之間的關係是查詢重點,例如社群網路、推薦 | Amazon Neptune(圖形資料庫) |
| 與 MongoDB 相容 | Amazon DocumentDB |
| 與 Apache Cassandra 相容 | Amazon Keyspaces |
| 全文搜尋、日誌搜尋 | Amazon OpenSearch Service |
ElastiCache 提供 Valkey、Redis OSS 與 Memcached 三種引擎。Valkey 與 Redis OSS 支援副本、Multi-AZ 自動切換、備份與排序集合(sorted set),排行榜、session 共用多半選它們;Memcached 只做單純的 key-value 快取,沒有副本與備份,適合可以隨時重建的快取。
摘要:同一類服務放在一起時,看的是決定機制的那句話。資料讀完要保留、多個應用程式讀完整資料是 Kinesis,一則訊息給一個消費者是 SQS,推給所有訂閱者是 SNS,依內容分流是 EventBridge。查詢條件多變、需要交易用 RDS,以 key 存取的大規模資料用 DynamoDB。同步複製的 Multi-AZ 解決可用性,非同步的 Read Replica 解決讀取量。快取依位置選 CloudFront、ElastiCache 或 DAX。頻繁的分析用 Redshift,不頻繁地查 S3 用 Athena。根網域指向 AWS 資源用 Alias。
某串流影音平台把使用者的觀看事件即時送到 AWS,尖峰時每秒數萬筆。推薦系統、即時儀表板與詐騙偵測三個團隊都需要讀取完整的事件資料,三者的處理速度各不相同,儀表板要在數秒內反映最新的事件。詐騙偵測團隊另外要求,修正程式錯誤後要能重新處理過去 3 天的事件。
哪一個方案最符合這些需求?
某公司使用一套 SaaS 客服系統,這套系統是 Amazon EventBridge 的 SaaS 夥伴,客服工單建立或更新時會產生事件。公司要把
priority欄位為urgent的工單事件立即交給一個 Lambda 函式通知值班人員,其餘事件寫入 SQS queue,供每日的批次作業處理。開發團隊不想自行架設接收事件的端點。
哪一個方案的維運負擔最低(LEAST operational overhead)?
priority 比對的 rule 分別送往 Lambda 與 SQS某零售公司把過去 5 年的銷售明細(約 20 TB)放在 Amazon RDS for MySQL 的 read replica 上,供 BI 工具產生儀表板。分析師每天執行數百次彙總查詢,每次都涵蓋多年的完整資料,常常要跑數十分鐘;交易用的主要資料庫運作正常。公司希望大幅縮短這些查詢的時間。
哪一個方案最符合成本效益(MOST cost-effective)?
某電子書平台的商品目錄存放在 us-east-1 的 Amazon RDS for MySQL(Multi-AZ DB instance)。平台開始服務歐洲使用者後,在 eu-west-1 部署了應用程式伺服器,但讀取目錄的延遲過高。目錄只由 us-east-1 的後台系統寫入,歐洲的讀取可以接受數秒內的資料延遲。
哪一個方案能以最低的成本降低歐洲的讀取延遲?
某電商網站以 Amazon ElastiCache(Valkey)快取 Amazon RDS 中的商品價格,採用 lazy loading,快取的資料沒有設定過期時間。價格有兩種更新途徑:營運人員在後台修改,經由應用程式寫入 RDS;每晚的批次作業則直接以 SQL 更新 RDS 中數萬筆價格。最近常有使用者看到舊的價格。公司要求價格更新後盡快反映,但資料庫的讀取負載不能大幅增加。
哪兩項做法的組合最符合這些需求?(選擇兩項)
Kinesis Data Streams 的資料在保存期限內一直保留,不會因為被讀取而刪除;三個團隊的應用程式各自記錄讀到的位置,處理速度不同也互不影響。把保存期限延長到 3 天以上(預設 24 小時),詐騙偵測團隊修正程式後,可以從 3 天前的位置重新讀取。資料寫入後數秒內就能讀到,滿足即時儀表板的需求。
A 是 SQS 的常見誤解:一則訊息只會由一個消費者處理,處理完就刪除,三個團隊會互相瓜分訊息,誰都拿不到完整資料。B 的 fan-out 讓每個團隊都拿到完整資料,只差一步:SQS 的訊息處理完就刪除,修正程式後無法重新處理過去 3 天的事件。D 的 Firehose 會先緩衝一段時間再批次寫入 S3,儀表板無法在數秒內反映最新事件。
EventBridge 可以直接接收 SaaS 夥伴的事件:在帳號中為 partner event source 建立 event bus,不必自己架設任何接收端點。rule 依事件內容比對,一個 rule 比對 priority 為 urgent 的事件送給 Lambda,另一個比對其餘的事件送進 SQS,路由完全由設定完成,不需要寫程式。
B 能依訊息屬性分流,但要自己架設 API Gateway 與 Lambda 接收 webhook,違反不自行架設端點的要求。C 少了依內容路由這一步:所有事件都送到 SNS topic,Lambda 與 SQS 會收到全部事件,緊急工單也會進到批次佇列。D 把判斷優先順序的邏輯放進 Lambda,而且 Lambda 從 queue 拉取全部事件後,批次作業就拿不到其餘的事件,需求無法成立。
彙總多年資料的分析查詢屬於 OLAP,Redshift 以欄式儲存與平行處理設計,只讀取查詢用到的欄位,執行這類查詢比交易用的 MySQL 快得多。以 DMS 持續把資料載入 Redshift,BI 工具改連 Redshift,主要資料庫不受影響。查詢每天數百次,固定規模的 Redshift 叢集費用可以預期。
A 仍然是為交易處理設計的資料庫,大範圍的彙總要逐列讀取,加記憶體與索引無法大幅改善。B 能查詢,但 Athena 依每次掃描的資料量計費,每天數百次、每次涵蓋多年的完整資料,累積的掃描費用會遠高於 Redshift;Athena 適合不頻繁的查詢。C 是誤解:DynamoDB 為以 key 存取設計,Scan 會讀取整個資料表,用來做大量彙總既慢又昂貴。
cross-Region read replica 以非同步方式把資料複製到 eu-west-1,歐洲的應用程式伺服器改從同一個 Region 的 replica 讀取,延遲就降下來了。題目接受數秒內的資料延遲,寫入也只發生在 us-east-1,非同步複製剛好符合需求,而且只需要多付一個 replica 的費用。
A 的 Multi-AZ DB cluster 的 reader 確實可以讀取,但它們都在 us-east-1,歐洲的讀取仍然要跨越大西洋,延遲沒有改善。C 能達成低延遲讀取,但要先把資料庫遷移到 Aurora,Global Database 也比一個 read replica 昂貴,題目不需要它在 Region 故障時一分鐘內接手寫入的能力。D 的快取放錯了位置:快取仍在 us-east-1,歐洲每次查詢還是要跨 Region。
兩種更新途徑要用不同的方式處理。後台的修改經過應用程式,可以在寫入 RDS 時同時更新快取(write-through),價格一修改快取就是新的。批次作業直接更新 RDS,不經過應用程式,快取不知道價格變了;為快取設定 TTL,舊價格最晚在 TTL 到期後失效,下一次讀取由 lazy loading 從 RDS 載入新價格。兩者都只在更新或過期時讀取資料庫,讀取負載不會大幅增加。
B 的 DAX 只能放在 DynamoDB 前方,無法替 RDS 快取。C 讓每一次讀取都打到資料庫,違反讀取負載不能大幅增加的要求。E 是反方向的做法:頁面在 CloudFront 快取 24 小時,價格更新後使用者看到舊價格的時間只會更長。


 iThome鐵人賽
 看影片追技術